Kimi K3.1: modelo aberto chinês chega perto do Opus, mas falha no teste do cavalo 3D
Segundo o @Fireship, o Kimi K3.1, da Moonshot, chega a um ponto do Opus num teste de programação, mas tropeça na animação de um cavalo 3D.
Em 3 pontos
- O Kimi K3.1 ficou a um ponto do Opus 5.5 no Terminal Bench 4.0, segundo o vídeo.
- A Moonshot reduziu a capacidade de hacking do modelo, de 90,5% para 81% nos testes.
- No teste do cavalo 3D, o Kimi tem visual bonito, mas animação fraca e nota 4,20.
Redação IA Seenup · via @Fireship
Em números
- 3 triparâmetros do modelo
- 67%nota na Artificial Analysis
- 90,5% → 81%testes de exploits resolvidos
- 4,20nota no Thoroughbench
Segundo @Fireship, no vídeo “China just dropped a new frontier model... and nobody can explain how”, a empresa chinesa Moonshot lançou o Kimi K3.1, um modelo de IA aberto com 3 trilhões de parâmetros. O criador diz que o desempenho dele deveria ser impossível, e mistura análise com bastante ironia.
O que o vídeo mostra
O criador conta que, na semana anterior, um modelo anônimo chamado Kibitz apareceu num ranking de comparação de IAs com desempenho de ponta. Todos teriam deduzido que era o Kimi. Na sexta-feira, a Moonshot o lançou oficialmente. Os pesos (os arquivos que permitem rodar o modelo) devem ficar disponíveis para baixar em 4 de novembro, "ou assim dizem", ironiza ele.
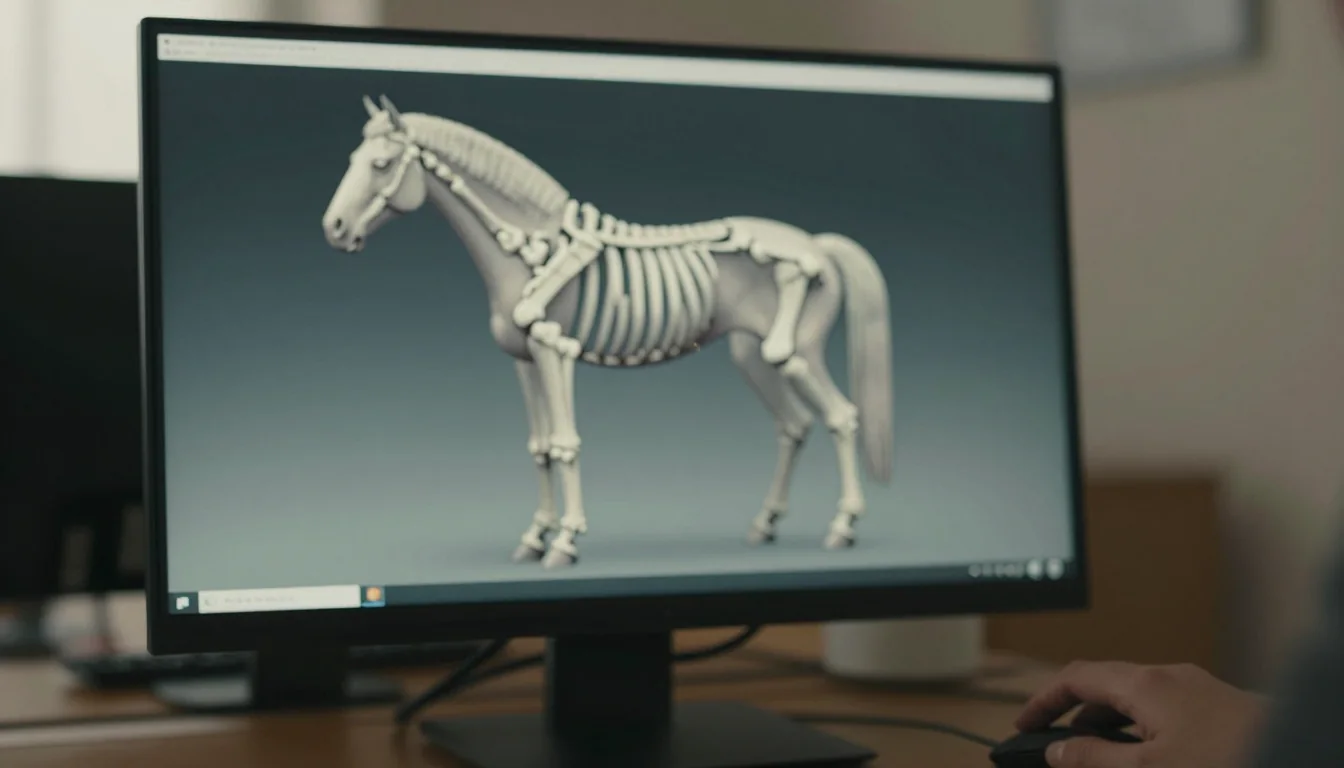
Depois, ele analisa os resultados e faz seu próprio teste: pedir um cavalo 3D realista e interativo feito com 3JS (uma biblioteca para gráficos 3D na web).
Principais pontos
- Contradição com as acusações: a Anthropic acusou a Moonshot e outras empresas chinesas de "destilação", isto é, usar as respostas do Claude para treinar modelos próprios. A empresa diz ter bloqueado de 90% a 99% desses ataques. Para o criador, se isso fosse verdade, o Kimi não deveria ter esse desempenho. Ele defende que a destilação é um "direito humano", opinião dele.
- Benchmark de programação: o Kimi K3.1 ficou a um ponto do Opus 5.5 no Terminal Bench 4.0, e nenhum outro modelo aberto chega perto. A Artificial Analysis rodou o teste de forma independente e deu 67%, a maior nota entre os modelos que testou. Ele lembra que o ambiente de execução (harness) influencia muito os resultados.
- Tarefas longas: o modelo também vai melhor num teste de requisitos de software de várias horas, que equivaleria a semanas de trabalho humano.
- Segurança digital: a Moonshot retirou dados de cibersegurança do treino. Um modelo sem esse filtro resolvia 90,5% dos testes de exploração de falhas; o lançado resolve 81%. Na leitura dele, é uma jogada para evitar proibições, já que os EUA baniram o Deepseek do governo federal. Ainda assim, o Kimi lidera o índice de ciberataques da Artificial Analysis, em boa parte porque Claude e GPT-6 recusaram todos os pedidos.
- Teste do cavalo: no "Thoroughbench", nota subjetiva de 0 a 10 criada por ele, Gemini Argon teve 0,69, GPT-6 Astra 5,21 e Opus 6,39. O Kimi, que ele precisou pagar 250 yuans por mês para usar, fez o cavalo mais bonito, mas com animação ruim, que apenas deforma a malha. O Claude montou um esqueleto com 35 ossos e cerca de 95 mil vértices. Nota final do Kimi: 4,20.
Vale assistir se…
Você quer acompanhar a disputa entre modelos abertos chineses e as big techs americanas, com um olhar crítico sobre benchmarks e um teste prático bem-humorado. Se prefere análise sem piadas, talvez ache o tom pesado. O vídeo traz ainda um trecho patrocinado, que ignoramos aqui.
O que muda
Antes
- Modelo sem filtro resolvia 90,5% dos testes de exploração de falhas
Depois
- Versão lançada resolve 81% desses testes
Entenda os termos
- Destilação
- Treinar um modelo usando as respostas de outro, mais avançado, para copiar parte do seu desempenho.
- Modelo aberto (open-weight)
- Modelo cujos arquivos podem ser baixados e rodados por qualquer pessoa, em vez de ficarem só num serviço fechado.
- Benchmark
- Teste padronizado usado para comparar o desempenho de diferentes modelos de IA.
Gostou? Compartilhe